Guide principal d’automatisation
Guide complet de l’automatisation par l’IA et des flux de travail pour freelances et TPE en 2026
Par Larbi Nokra · Mis à jour · 12 min de lecture
Transparence éditoriale : certains liens de cette analyse sont des liens affiliés. Si vous souscrivez via ces liens, NexoFlujos peut percevoir une commission sans frais supplémentaires pour vous, ce qui nous permet de garder nos analyses indépendantes. En savoir plus
Prix de Make et Zapier vérifiés le 21 oct. 2026 · Sources officielles
 Automatisez votre activité avec Make : forfait gratuit de 1 000 crédits par mois
Essayer Make gratuitement (s’ouvre dans un nouvel onglet)Lien affilié
Sur cette page
Une méthode pour choisir votre premier flux, le rendre fiable, décider où l’intelligence artificielle a du sens et choisir une plateforme sans payer trop cher.
Ce qu’est (et n’est pas) l’automatisation d’un flux de travail
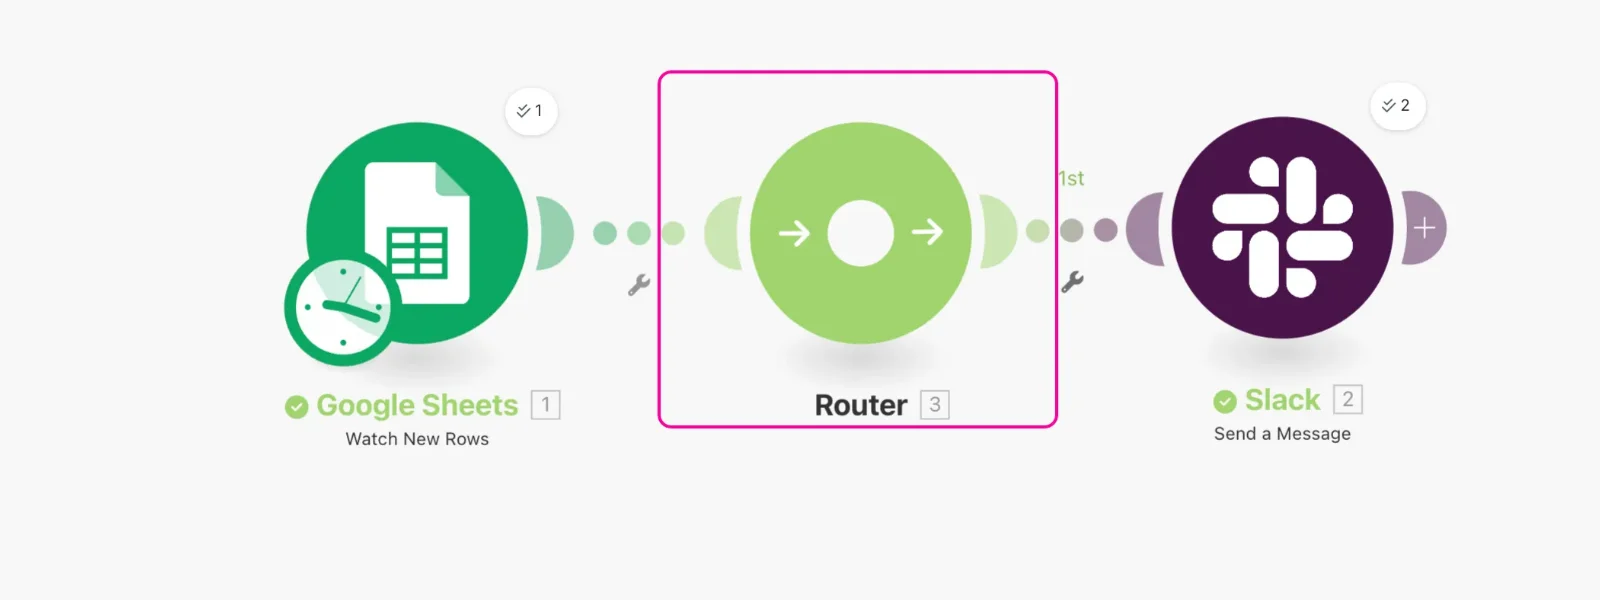
Automatiser, c’est laisser un système exécuter, sans intervention manuelle, une suite d’étapes que vous faites aujourd’hui à la main : recevoir une donnée, la vérifier, l’enregistrer, prévenir quelqu’un. Un flux de travail est cette suite écrite de façon qu’une machine puisse la suivre : un déclencheur (quelque chose se produit), des transformations (la donnée est nettoyée ou enrichie) et des actions (on écrit dans une autre application ou on envoie un message).
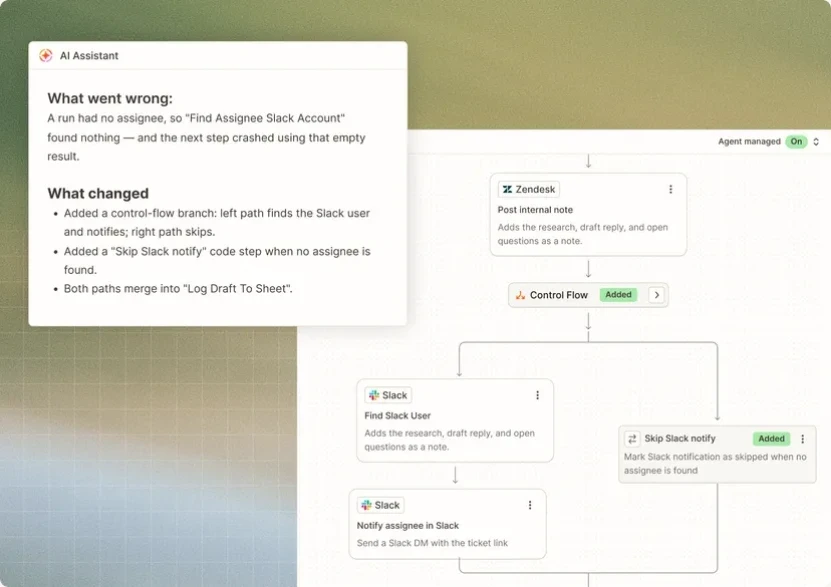
L’intelligence artificielle ajoute une quatrième brique facultative : une étape capable d’interpréter un texte libre, de le classer ou de rédiger un brouillon. Elle ne remplace pas le flux ; elle occupe une étape précise à l’intérieur. C’est pourquoi il vaut mieux comprendre d’abord le flux et décider ensuite si l’une de ses étapes a besoin d’IA.
Ce que l’automatisation n’est pas : un moyen de réparer un processus confus. Si deux personnes accomplissent la même tâche de manières différentes, un flux automatique ne fera que reproduire la confusion plus vite. La règle pratique est simple : si vous ne pouvez pas expliquer la tâche en cinq phrases, elle n’est pas encore prête à être automatisée.
En un coup d’œil
| Outil | Idéal pour | Prix | Essai gratuit / CTA |
|---|---|---|---|
| Make | Flux visuels avec branches et données complexes | ~8,01 €/mois Officiel : 9 $/mois (Core, 10 000 crédits, annuel) | 1 000 crédits par moisEssayer Make gratuitement (s’ouvre dans un nouvel onglet)Lien affilié |
 Zapier | Flux linéaires rapides à monter | 18,28 €/mois Officiel : 19,99 $/mois (Professional, 750 tâches, annuel) | 100 tâches par moisVoir les prix officiels (s’ouvre dans un nouvel onglet) |
 n8n | Équipes techniques capables d’auto-héberger | 20 €/mois (Starter, facturation annuelle) | Community auto-hébergéeVoir les prix officiels (s’ouvre dans un nouvel onglet) |
Comment choisir et définir votre premier flux
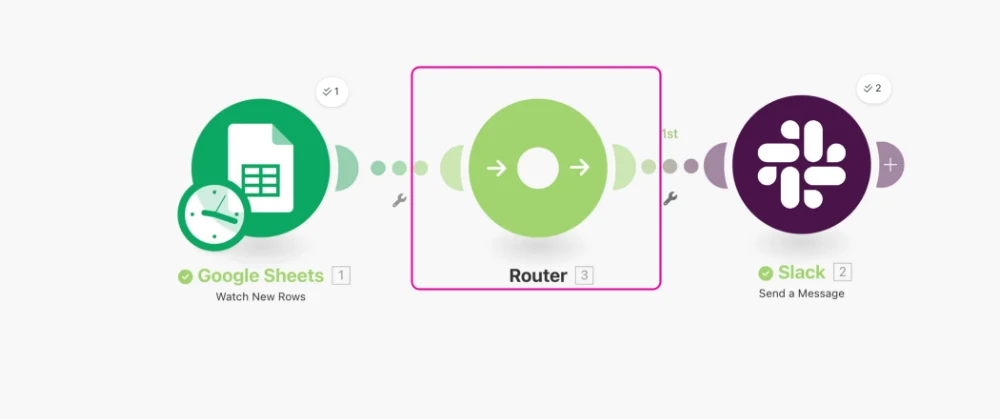
Un bon premier flux remplit quatre conditions. Il se répète souvent (chaque jour ou chaque semaine), suit des règles que vous pouvez écrire, a une erreur peu coûteuse (s’il échoue, on corrige sans conséquence grave) et produit un résultat que vous pouvez vérifier d’un coup d’œil.
- Bons candidats : enregistrer les demandes d’un formulaire dans un tableur ou un CRM, envoyer une alerte quand une facture reste impayée trop longtemps, archiver les pièces jointes d’e-mails dans des dossiers au nom cohérent.
- Mauvais candidats pour commencer : les processus aux décisions délicates (conditions commerciales, remboursements), les tâches qui n’arrivent qu’une fois par an et toute étape dont l’erreur touche un client sans possibilité de la corriger.
La fiche du processus
Avant d’ouvrir le moindre outil, remplissez une fiche de six champs. C’est le document le plus utile de tout le projet : si vous ne parvenez pas à la compléter, le flux n’est pas prêt.
| Champ | Ce qu’il doit dire | Exemple |
|---|---|---|
| Entrée | Quel événement lance le travail et où il se produit. | Un formulaire web envoie un nom, une adresse e-mail et la description du projet. |
| Données obligatoires | Les informations sans lesquelles on ne peut pas continuer. | Une adresse e-mail valide et une description d’au moins une phrase. |
| Règles | Conditions précises pour accepter, refuser ou revoir. | Si l’e-mail manque, la demande est écartée. Si un budget est indiqué, elle est marquée comme prioritaire. |
| Sortie | Ce qui doit exister à la fin et où. | Une ligne dans la feuille des demandes et une alerte à la personne responsable. |
| Exceptions | Ce qui se passe quand quelque chose ne colle pas ou échoue. | Doublons, adresses e-mail mal saisies, service indisponible. |
| Responsable | Qui examine les échecs et à quelle fréquence. | Une personne précise, chaque matin. |
Anatomie d’un flux fiable
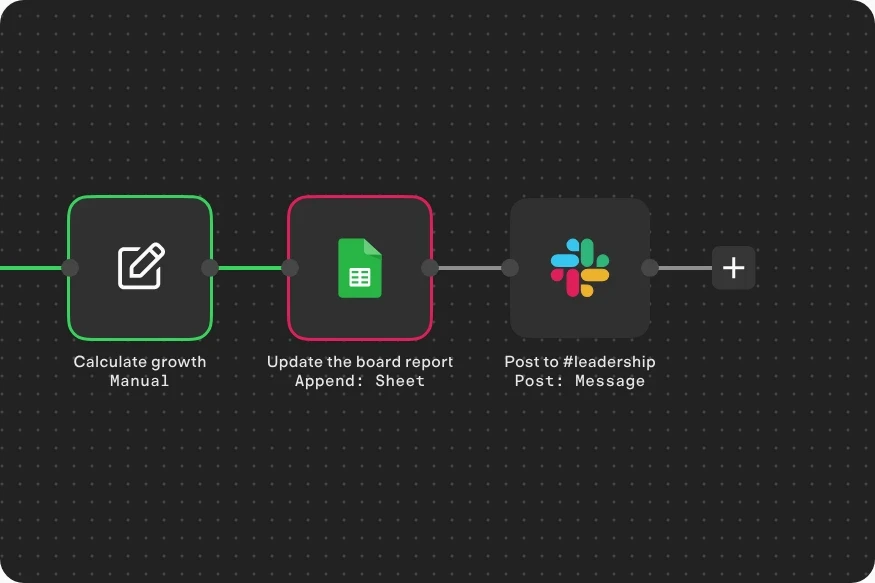
FIG 01 // FLUX
Un flux qui fonctionne une fois avec des données parfaites est une démonstration ; un flux fiable continue de fonctionner quand arrivent des données incomplètes, en double ou dans le désordre. Quatre décisions font la différence.
1. Le déclencheur : webhook ou interrogation périodique
Un webhook est une adresse web qu’une autre application appelle dès que quelque chose se produit ; l’information arrive instantanément. L’interrogation périodique (polling) vérifie à intervalles réguliers s’il y a du nouveau ; elle est plus simple, mais introduit un délai. Les plateformes limitent la fréquence minimale d’interrogation selon le forfait : le délai ne se réduit donc pas toujours en payant moins.
2. Les données : validez avant d’agir
Vérifiez que les champs obligatoires existent et ont le format attendu avant d’écrire où que ce soit. Un exemple de charge utile d’un formulaire :
{
  "id_envoi": "f-20261015-0042",
  "nom": "Claire Martin",
  "email": "claire@exemple.fr",
  "message": "J’ai besoin d’un site avec réservation en ligne.",
  "budget_indique": null
}
3. L’idempotence : répéter ne doit pas dupliquer
Les plateformes réessaient quand quelque chose échoue, et les services envoient parfois deux fois le même événement. Un flux est idempotent si l’exécuter deux fois avec la même donnée produit le même résultat qu’une seule fois. La technique habituelle consiste à construire une clé unique à partir de la donnée et à vérifier si elle existe déjà avant de créer quoi que ce soit :
// Pseudo-code pour une étape de code du flux
const cle = `${entree.id_envoi}`;
const dejaExistant = await chercherEnregistrement(cle);
if (dejaExistant) return { ignore: true, motif: "doublon" };
return { ignore: false, cle };
4. Les erreurs : détecter, alerter et pouvoir reprendre
Décidez à l’avance ce que fait le flux face à chaque échec et qui en est informé. Un flux qui échoue en silence est pire que pas de flux, car personne ne sait qu’il y a du travail en attente.
| Échec | Cause typique | Réponse recommandée |
|---|---|---|
| Donnée incomplète | Champ obligatoire vide | Écarter ou envoyer en revue manuelle avec une alerte. |
| Doublon | Nouvelle tentative ou double envoi | Vérifier la clé unique et ignorer. |
| Identifiant expiré | Renouvellement des autorisations en attente | Alerte immédiate au responsable ; reprendre après le renouvellement. |
| Service indisponible | Panne ou limite d’usage du fournisseur | Réessayer avec un délai croissant ; alerter si cela persiste. |
| Réponse inattendue | Changement du format de l’API | Conserver l’exécution échouée pour l’examiner. |
Données, API et webhooks sans mauvaises surprises
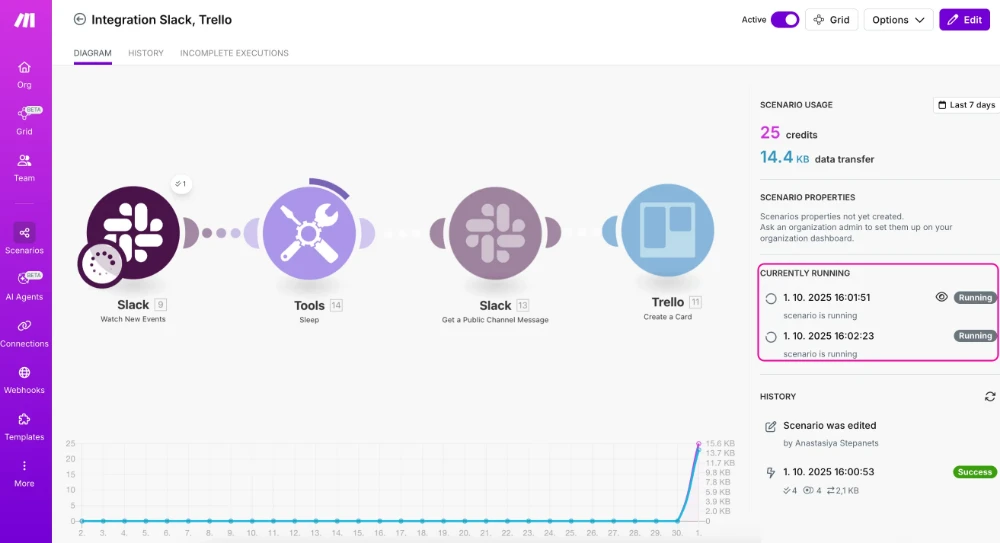
FIG 03 // ARCHITECTURE
La même architecture fonctionne avec d’autres plateformes :n8nZapier
Presque toutes les intégrations reposent sur une API : l’ensemble des opérations qu’une application permet de réaliser depuis l’extérieur. Qu’une application figure au catalogue d’une plateforme ne prouve pas que vous pourrez faire avec elle tout ce dont vous avez besoin. Avant de concevoir le flux, vérifiez quatre choses dans la documentation du service :
- Authentification : comment l’accès est accordé (clé d’API ou OAuth) et quand il expire.
- Autorisations : quelles données la connexion peut lire et écrire ; n’accordez que le nécessaire.
- Limites : combien de requêtes par minute le service admet. Les dépasser provoque des erreurs temporaires.
- Pagination : si une requête renvoie beaucoup d’enregistrements, ils arrivent par tranches ; le flux doit demander toutes les tranches.
Quand le catalogue ne propose pas l’opération dont vous avez besoin, les plateformes permettent généralement d’appeler l’API directement avec une étape générique de requête HTTP. C’est plus de travail, mais cela évite de dépendre de la création d’un connecteur par quelqu’un d’autre.
Où l’intelligence artificielle trouve sa place (et où elle n’en a pas)
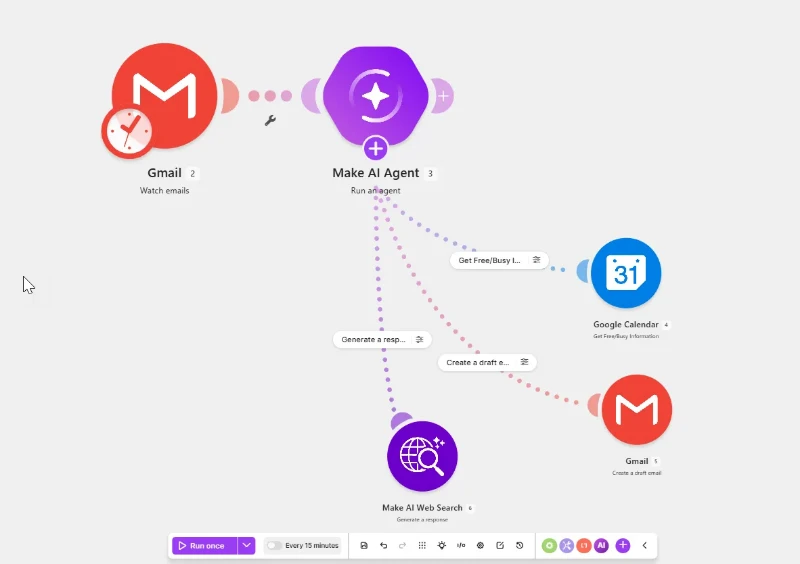
La règle qui marche le mieux en pratique : utilisez des règles fixes pour ce qui est prévisible et l’IA seulement pour ce qui est ambigu. Une règle fixe est peu coûteuse, rapide et donne toujours le même résultat. Un modèle de langage est flexible, mais il a un coût d’usage, peut se tromper et ne garantit pas la même réponse pour la même entrée.
| Tâche | Approche recommandée | Raison |
|---|---|---|
| Copier un champ d’une application vers une autre | Règle fixe | Il n’y a aucune ambiguïté. |
| Classer des e-mails par catégories | IA avec catégories fermées | Le langage libre est ambigu ; la réponse est limitée à une liste. |
| Extraire des données d’un texte désordonné | IA avec sortie structurée et validation | On exige un format et on rejette ce qui ne le respecte pas. |
| Rédiger une réponse à un client | IA pour le brouillon, une personne pour l’envoi | L’erreur arrive chez le client : quelqu’un doit la relire. |
| Décider d’un remboursement ou d’une remise | Ne pas automatiser avec l’IA | Décision à impact financier et juridique. |
Quatre pratiques pour utiliser l’IA dans un flux
- Demandez une sortie structurée et validez-la. Si le modèle doit renvoyer une catégorie, n’acceptez que celles de votre liste et traitez toute autre réponse comme une erreur.
- Testez sur un échantillon réel avant d’activer. Réunissez de vingt à cinquante exemples dont la bonne réponse est connue et vérifiez combien l’étape d’IA en réussit. N’activez pas le flux si vous ne connaissez pas ce pourcentage.
- Gardez une personne dans la boucle quand le résultat part vers un client ou touche à l’argent.
- Notez le coût. Les fournisseurs de modèles facturent à l’usage et les plateformes peuvent appliquer leur propre consommation aux fonctions d’IA. Estimez le coût mensuel avant de décider.
Données personnelles : envoyer des noms, des adresses e-mail ou des messages de clients à un modèle de langage est un traitement de données personnelles. Examinez le contrat du fournisseur et la base juridique avant de le faire (plus de détails dans la section sur le RGPD).
Essayez Make avec son forfait gratuit : 1 000 crédits par mois
Essayer Make gratuitement (s’ouvre dans un nouvel onglet)Lien affilié
Choisir une plateforme : les critères qui comptent
Il n’existe pas de « meilleure » plateforme dans l’absolu. La bonne dépend de la personne qui maintiendra les flux, des données manipulées et du nombre d’exécutions attendu. Voici les critères qui pèsent le plus :
- Comment la consommation est comptée. Chaque plateforme facture avec une unité différente (exécutions complètes, crédits par action ou tâches). Un même flux peut consommer des chiffres très différents selon l’unité.
- Où il s’exécute. Un service hébergé par le fournisseur réduit la maintenance ; une installation personnelle donne le contrôle des données, mais vous rend responsable du serveur.
- Limites d’exécution. La fréquence minimale d’interrogation, les exécutions simultanées et la durée maximale varient selon le forfait.
- Connecteurs disponibles pour les applications que vous utilisez aujourd’hui, et possibilité d’appeler une API quand le connecteur manque.
- Qui va le maintenir. Un outil puissant que personne ne sait corriger devient une dette.
Si vous savez déjà quel processus automatiser et que vous comparez des options, notre comparatif n8n, Make et Zapier explique, avec des prix vérifiés et des limites documentées, comment chacune facture, et propose un pilote pour décider à partir de votre propre cas plutôt que de vous fier à un classement.
Service hébergé ou installation personnelle : ce que vous assumez avec un VPS
Certaines plateformes, comme n8n, permettent d’exécuter le programme sur votre propre infrastructure. La documentation de n8n décrit plusieurs voies d’installation et recommande Docker Compose pour les environnements de production avec base de données. Un serveur privé virtuel (VPS) avec stockage NVMe est une option courante pour l’héberger.
L’avantage, c’est le contrôle : vous décidez où vivent les données et comment sont faites les sauvegardes. Le coût caché, c’est le travail que faisait auparavant le fournisseur :
- Mises à jour du programme et du système d’exploitation.
- Sauvegardes de la base de données et des identifiants, avec un test de restauration périodique.
- Sécurité : accès restreint par clé, pare-feu, certificat HTTPS et panneau d’administration non exposé sans protection.
- Supervision : quelqu’un doit être prévenu si le serveur n’a plus de disque ou de mémoire.
Si personne ne peut assumer cette maintenance, un service hébergé est souvent moins cher au total, même si l’abonnement mensuel paraît plus élevé. Si vous décidez de l’héberger vous-même, partez de la documentation officielle d’hébergement de n8n (s’ouvre dans un nouvel onglet).
Données personnelles et RGPD dans vos automatisations
Si votre flux manipule des données de personnes identifiables (clients, candidats, contacts), le Règlement général sur la protection des données (RGPD) s’applique à vos automatisations comme au reste de votre activité. Cette section est une orientation générale, pas un conseil juridique.
- Minimisez : le flux ne doit déplacer que les données dont il a besoin. Supprimez les champs inutiles.
- Connaissez vos sous-traitants : la plateforme d’automatisation et chaque application connectée traitent des données pour votre compte. Examinez leur contrat de sous-traitance.
- Localisation et transferts : vérifiez où les données sont stockées et quelles garanties le fournisseur offre si elles sont hors de l’Espace économique européen.
- Conservation : définissez combien de temps les journaux du flux sont conservés. Les historiques d’exécution contiennent aussi des données.
- Modèles d’IA : appliquez ce qui précède au fournisseur du modèle et évitez d’envoyer des données qui ne sont pas indispensables.
Plan de 30 jours pour votre premier flux
- Semaine 1 · Choisir et décrire. Choisissez un processus, remplissez la fiche et notez le temps qu’il vous coûte aujourd’hui chaque semaine.
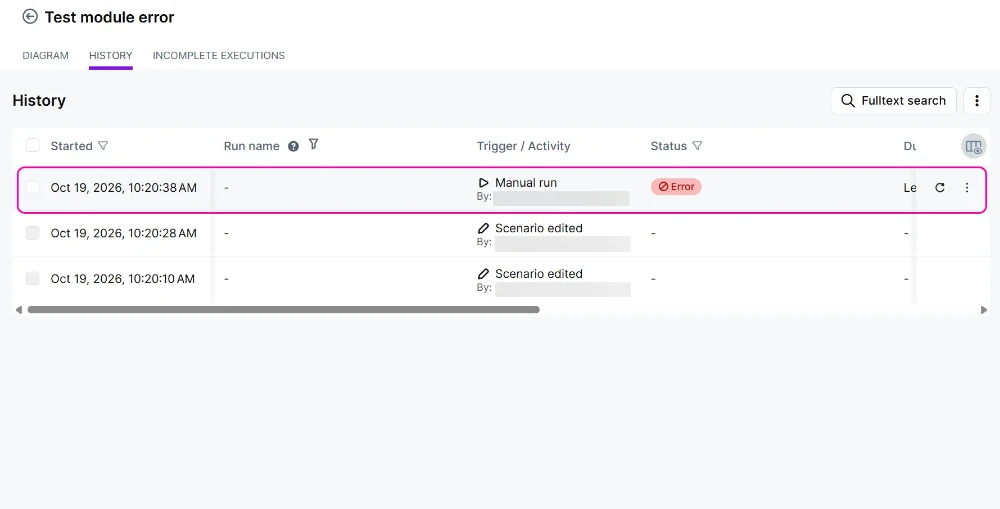
- Semaine 2 · Construire la version minimale. Déclencheur, validation et une seule action, testés avec des données fictives. Ajoutez l’alerte d’erreurs dès le départ.
- Semaine 3 · Tester les mauvais cas. Donnée incomplète, doublon, service indisponible, identifiant expiré. Corrigez ce qui échoue.
- Semaine 4 · Activer sous supervision. Laissez-le tourner, examinez chaque jour les échecs et comparez le temps gagné à l’estimation initiale.
C’est seulement après ce cycle qu’il a du sens d’ajouter une étape d’IA ou d’étendre le flux.
Erreurs fréquentes
- Automatiser un processus qui n’est pas encore clair.
- Construire le chemin heureux sans tester doublons ni données incomplètes.
- Ne prévenir personne quand le flux échoue.
- Choisir la plateforme d’après le prix d’entrée sans estimer la consommation réelle.
- Connecter un compte personnel plutôt qu’un compte de service aux autorisations limitées.
- Envoyer des données personnelles à un modèle d’IA sans examiner le contrat du fournisseur.
Liste de contrôle avant d’activer
- La fiche du processus est complète et quelqu’un d’autre que son auteur l’a relue.
- Le flux valide les données obligatoires avant d’agir.
- Répéter une exécution ne crée pas de doublons.
- Il y a une alerte pour chaque type d’échec et une personne chargée de la traiter.
- Les identifiants n’ont que les autorisations nécessaires et on sait quand ils expirent.
- La consommation mensuelle a été estimée dans l’unité de la plateforme choisie.
- S’il y a des données personnelles, le sous-traitant et la conservation ont été examinés.
Questions fréquentes
Dois-je savoir programmer pour automatiser ?
Pas pour commencer. Les plateformes de cet article proposent des éditeurs visuels. Cela dit, comprendre ce qu’est une API, un webhook et un format comme JSON vous évitera des blocages quand quelque chose échoue.
Avec combien d’exécutions faut-il commencer ?
Avec peu, et sous supervision. L’objectif du premier mois est d’apprendre comment votre processus échoue, pas de gagner un maximum de temps.
L’IA est-elle nécessaire dans un premier flux ?
Non. Beaucoup de flux utiles se règlent avec des règles fixes. Ajoutez l’IA quand vous trouvez une étape avec du texte libre que les règles ne savent pas traiter.
Que se passe-t-il si je change de plateforme plus tard ?
Ce qui migre bien, c’est la fiche du processus et la logique ; ce qui ne migre pas, ce sont les flux construits. C’est pourquoi il vaut mieux documenter le processus en dehors de l’outil.
Sources et méthodologie
Cet article s’appuie sur la documentation officielle des plateformes et sur un jugement éditorial. Il ne présente pas de résultats de tests de performance propres. Pour les conditions de chaque service, consultez toujours la source du fournisseur :
- Documentation d’hébergement de n8n
- Scénarios dans le centre d’aide de Make
- Comment l’usage des tâches est mesuré dans Zapier
La politique éditoriale complète figure sur la page À propos de Larbi Nokra et de la méthode de NexoFlujos.
Articles liés
 Guide
Prix de Make en 2026 : crédits, forfaits et coût réel
Forfaits Make (ex-Integromat) avec prix officiels vérifiés et leur estimation en euros : ce qui consomme des crédits, modules d’IA et exemple de calcul. Comparatif
Make vs Zapier vs n8n 2026 : prix en euros et limites
Comparez Make, Zapier et n8n avec des prix officiels vérifiés et leur estimation en euros, les limites documentées et un pilote pour décider selon votre cas.